 PmaControl
 两次收到相同的观测时,需要识别重复数据,以免再次开启或关闭事件。原先,应用先向 MariaDB 查询最近一次观测的日期,再查刚收到的点。我们省掉了第一次读取。
在五项真实检查中,重放的 SQL 读取耗时中位数从 6.645 降至 0.363 毫秒,减少 95%。在实验环境中,包含锁和写入的完整事务中位数从 2.554 降至 0.904 毫秒。应用补丁已测试,尚待部署。
以时区检查为例,逐条看查询
11 月 21 日 22:29:19,时区一致性检查发出告警。如果再次收到同一条观测,会发生什么?原实现先执行下面的查询。? 是该检查的指纹,在两条查询中取值相同。
EXPLAIN PARTITIONS
SELECT observed_at
FROM pmc_alert_level_point
WHERE fingerprint = UNHEX(?)
ORDER BY observed_epoch DESC, observed_at DESC
LIMIT 1;
应用只根据查到一行来判断历史是否存在,随后还要查找精确的观测并读取状态。选定的实现直接从这一步开始。观测点和状态一致即可认定为重放,同一时刻的状态发生冲突则报错。
EXPLAIN PARTITIONS
SELECT is_open
FROM pmc_alert_level_point
WHERE fingerprint = UNHEX(?)
  AND observed_epoch = 1795296559
  AND observed_at = '2026-11-21 22:29:19.000000';
以下是服务器针对同一项检查生成的执行计划。 第一列结果对应已删除的读取,第二列对应足以识别重放的读取。
| EXPLAIN PARTITIONS | 最近日期 | 精确观测点 |
|---|---|---|
访问类型 (type) |
range |
const |
索引 (key) |
PRIMARY |
PRIMARY |
键字节数 (key_len) |
32 | 48 |
引用 (ref) |
— | const,const,const |
预估行数 (rows) |
8,617 | 1 |
| 计划中的分区 | 45 | 1 (p740307) |
| Extra | Using where; Using index |
— |
两条查询都使用 PRIMARY。前者只限定 32 字节的指纹,计划中保留 45 个分区。后者还限定 epoch 和日期,覆盖复合键的全部 48 个字节。MariaDB 可以直接定位到当天分区中的唯一键。
rows 中的 8,617 为估算值。一次 ANALYZE FORMAT=JSON 显示第一条查询的迭代器返回一行(r_rows = 1,r_loops = 1),与 LIMIT 1 一致。这些计数器不衡量分区内部的索引查找。11 月 19 日至 21 日,该摘要累计记录 1,643,071 次调用,SQL 总耗时 8 小时 08 分钟。
查看五项检查的全部 20 份 MariaDB 执行计划(文本)
测试的是哪五项检查
摘要页显示了同一 SQL 的五次执行,分别使用五个 fingerprint 值。每个值标识一个监控条件。我们从对应观测中读取了规则名称。括号中的字母与 CSV 中的标记对应。
| 检查(CSV 标记) | 规则代码 | 告警点数 / 总数 |
|---|---|---|
| Performance Schema 启用状态 (A) | AdvisorPerformanceSchema |
0 / 5,692 |
| 时区一致性 (B) | AdvisorTimeZoneAlignment |
5,694 / 5,695 |
| Galera 状态传输方式(SST) (C) | AdvisorWsrepSstMethod |
0 / 5,692 |
| Galera 事务应用线程 (D) | AdvisorWsrepSlaveThreads |
0 / 5,692 |
| Galera 节点名称 (E) | AdvisorWsrepNodeName |
0 / 5,692 |
这五个重放点的时刻都是 11 月 21 日 22:29:19,当时只有时区检查处于告警状态。图中的每条线连接原读取路径的中位数和改为先查精确点后的中位数。
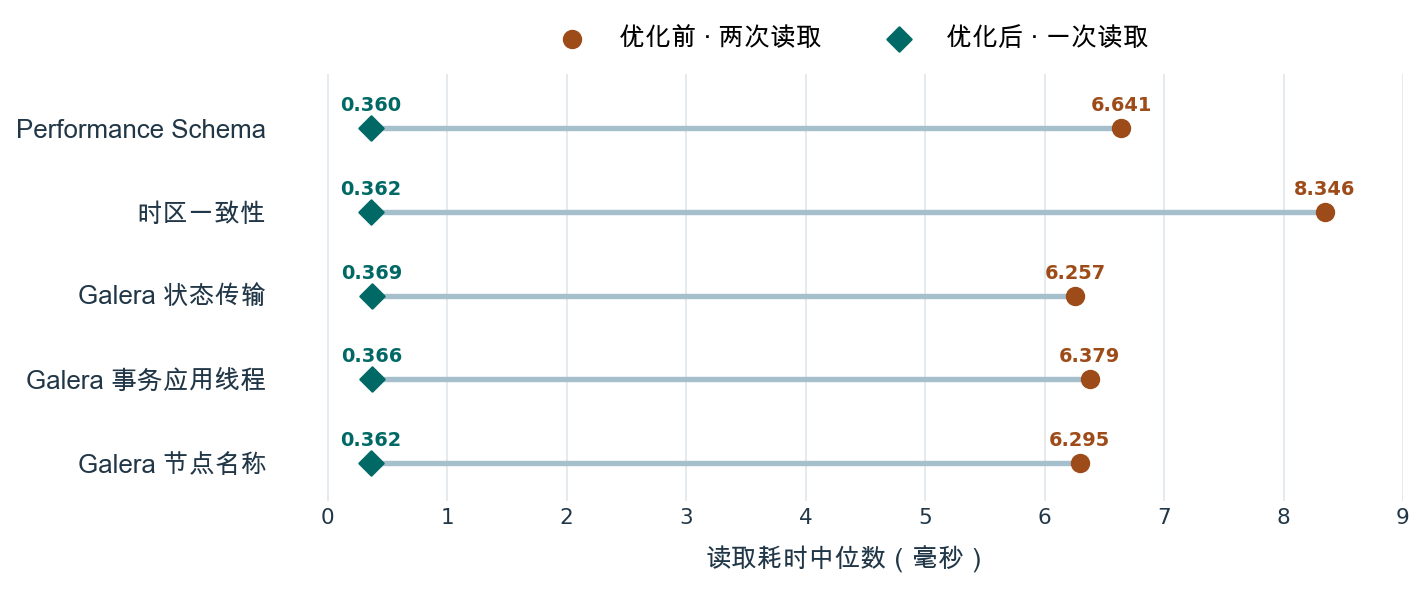
在观测服务器上,每项检查的每个版本运行 50 次。末行汇总该版本的全部 250 次测量。两张表的 SQL 耗时均以毫秒为单位。
重放已有观测点 · 从两次读取减为一次
| 检查 | 优化前平均值 | 优化后平均值 | 优化前中位数 | 优化后中位数 |
|---|---|---|---|---|
| Performance Schema 启用状态 | 7.171 | 0.372 | 6.641 | 0.360 |
| 时区一致性 | 8.808 | 0.400 | 8.346 | 0.362 |
| Galera 状态传输方式(SST) | 7.372 | 0.575 | 6.257 | 0.369 |
| Galera 事务应用线程 | 6.970 | 0.389 | 6.379 | 0.366 |
| Galera 节点名称 | 7.132 | 0.374 | 6.295 | 0.362 |
| 五项检查合计 | 7.491 | 0.422 | 6.645 | 0.363 |
向已有历史添加观测点 · 从四次读取减为三次
| 检查 | 优化前平均值 | 优化后平均值 | 优化前中位数 | 优化后中位数 |
|---|---|---|---|---|
| Performance Schema 启用状态 | 39.832 | 29.522 | 29.189 | 26.465 |
| 时区一致性 | 41.518 | 32.461 | 35.533 | 29.123 |
| Galera 状态传输方式(SST) | 39.431 | 31.138 | 31.509 | 28.157 |
| Galera 事务应用线程 | 36.855 | 31.667 | 33.790 | 25.943 |
| Galera 节点名称 | 39.696 | 31.043 | 35.195 | 28.511 |
| 五项检查合计 | 39.466 | 31.166 | 33.243 | 27.975 |
为什么新增点的收益较小
迟到的观测可能落在两个已保存点之间,从而改变事件区间。找不到精确键时,应用按 (observed_epoch, observed_at) 顺序查前驱和后继。只要找到任一相邻点,就能同时确认历史存在。
以下为时区检查在新增场景中的两条相邻点查找计划,参数时间为 11 月 22 日 22:29:19。即使省掉最近日期查询,这两次读取仍有成本。
| 相邻点 | 访问类型 | 索引 | 分区 | 预估行数 |
|---|---|---|---|---|
| 前驱 | range |
PRIMARY |
45 | 8,653 |
| 后继 | range |
PRIMARY |
45 | 81 |
V1 是原实现。V2 删除最近日期查询,利用精确点及其相邻点。三次都未命中时,程序检查旧版本是否保留了可导入的状态。第一组试验中,恢复操作的中位数从 9.665 升至 12.963 毫秒,因为 V2 在刚刚确认空白的历史里又查了一遍相邻点。
选定的 V3 直接处理这种情况。如果历史为空,且没有旧事件,就按原日期、epoch 和内容恢复唯一留存的正常观测点,然后在同一把锁下检查传入的点。
实验环境的完整事务,平均值 / 中位数,单位为毫秒。 PHP 计时包括加锁、读取、写入、COMMIT 和释放锁。
| 操作 | V1 · 原实现 | V2 · 删除首次查询 | V3 · 直接恢复 |
|---|---|---|---|
| 重放已知点 | 3.954 / 2.554 | 1.586 / 0.924 | 1.518 / 0.904 |
| 向已有历史新增点 | 23.907 / 17.297 | 23.516 / 13.954 | 22.895 / 14.017 |
| 创建第一个点 | 28.373 / 10.477 | 20.031 / 8.689 | 22.708 / 8.660 |
| 恢复旧版正常点 | 23.609 / 10.422 | 29.137 / 13.423 | 17.151 / 7.916 |
V2 与 V3 的主要区别在于恢复旧状态,常规新增的中位数接近。三个版本的决定、观测点、事件、区间和最新状态完全一致。
能否用 fingerprint 作为主键?
11 月 20 日共有 543,719 个点,分属 9,478 个指纹。其中一个指纹当天出现 83 次。指纹标识一项检查,三元组 (fingerprint, observed_epoch, observed_at) 标识该检查的一次观测。
SHOW INDEX 对首列前缀的基数估算为 3,672,630,两个更长前缀的估算均为 2,448,420。增加一列不可能使真实组合数下降,倒挂来自估算。在按日分区的副本上,PRIMARY KEY(fingerprint) 触发错误 1503,因为每个唯一键都必须包含 observed_at。在无分区副本上,第二条相同指纹的观测触发重复键错误 1062。 MariaDB · SHOW INDEX · MariaDB · Partitioning
判断历史存在的其他写法
耗时汇总五项检查,展示的计划对应时区一致性检查。箭头代表未命中时回查完整历史,横线代表无分区表。每组实验均有自己的基线。
| 组别与查询 | 访问类型 / 索引 | 分区 | 平均 / 中位数(ms) |
|---|---|---|---|
| I · 最近日期 | range / PRIMARY |
45 | 7.577 / 6.660 |
I · 最近日期,FORCE INDEX (PRIMARY) |
ref / PRIMARY |
45 | 4.927 / 4.283 |
I · SELECT 1 … LIMIT 1 |
ref / level_neighbour |
45 | 6.361 / 5.434 |
I · SELECT EXISTS(…) |
ref / level_neighbour |
45 | 6.870 / 5.625 |
| I · 在历史中验证最新状态,必要时回查 | const / PRIMARY + const / PRIMARY → ref / level_neighbour |
— + 45 → 45 | 4.543 / 3.995 |
| II · 最近日期 | range / PRIMARY |
45 | 6.401 / 5.623 |
| II · 先查观测日,必要时回查 | ref / level_neighbour_epoch → ref / level_neighbour |
1 → 45 | 3.739 / 3.411 |
| II · 仅读取最新状态 | const / PRIMARY |
— | 0.277 / 0.257 |
仅读取最新状态在 250 次比较中全部返回了相同日期。但表中可能残留旧版本保存的状态,也可能保留已被清理的历史点的状态。仅凭该表无法决定是否需要重建历史。
时间索引和分区布局有何作用
我们在 MariaDB 11.8.10 和 MyRocks 上,对 621,865 个完全一致的观测点执行原有的有序查询,以比较布局。计划针对时区检查。候选时间索引为 when_observed(observed_epoch, observed_at)。
| 表布局 | 访问类型 / 索引 | 计划中的分区 | 平均 / 中位数(ms) |
|---|---|---|---|
| 复合键、按日分区 | range / PRIMARY |
45 | 612.119 / 549.937 |
| 增加时间索引 | range / PRIMARY |
45 | 637.779 / 525.603 |
| 强制使用时间索引 | index / when_observed |
45 | 64.429 / 48.306 |
| 无分区表 | range / PRIMARY |
— | 14.052 / 7.676 |
| 按指纹划分 16 个分区 | ref / PRIMARY |
1 | 0.786 / 0.410 |
增加时间索引后,优化器对五项检查仍选择 PRIMARY。强制使用 when_observed 得到 index 扫描,按日期查到匹配指纹为止。按指纹分区可以定位到 16 个分区中的一个,但按日清理数据的方案也需要调整。
实验环境限一个 CPU、96 MiB MyRocks 块缓存。对第一份 571,957 个点的副本,基线中位数为 1.350 毫秒,扩充副本后为 549.937 毫秒。两组差异的原因尚未确定。这些数据用于同组布局比较,生产延迟和迁移成本需要另行测量。
测量方法和下载
我们固定了摘要页同时显示的五个例子。50 轮中,每轮用固定种子的随机数生成器打乱参数和版本的顺序。每项检查每个版本 50 个样本,每个版本共 250 个样本。首次执行和延迟尖峰均包含在内。服务器对比使用只读快照,关闭结果缓存,并通过 SHOW PROFILES 计时。
带写入的事务在各自独立的 45 分区副本上运行,使用五项检查的 28,463 个历史键和合成告警内容。还测试了迟到点、夏令时切换、冲突及回滚后重试。压缩包包含逐次测量、SQL 变体和每项检查的完整计划。
PmaControl 最终选了什么
回到时区观测。在 50 次重放中,读取平均耗时从 8.808 降至 0.400 毫秒,中位数从 8.346 降至 0.362 毫秒。识别重放只需要检查标识、时刻和已保存的状态。我们保留 V3 和复合主键。 一次查找足以识别此次重放,历史记录也能正确接收下一个迟到点。
评论 (0)
暂无评论。
发表评论